LLMに任せすぎない業務フロー制御――AI受付アバター「Virtual Concierge」を支えるハーネス設計
AI業務活用シリーズ|AI受付アバター「Virtual Concierge」で学ぶ実践知|第3回
- 更新日
- 公開日
- 2026.11.12


LLMを業務システムに組み込むと、「会話はできるのに、決められた業務フローを守れない」という問題が起こることがあります。
本記事は、AI受付アバター「Virtual Concierge」の開発・検証で得られた知見を紹介するシリーズの第3回です。第1回ではシステムの仕組みと開発背景、第2回では業務AIに必要な3つの設計ポイントを紹介しました。今回は、その1つ目「LLMと業務フロー制御の役割を分ける」を掘り下げます。
PoCでは、LLMが必要な確認を飛ばす、事実にない情報を案内する、意図しない終了処理へ進もうとするなど、受付フローとして不安定な挙動が見られました。
まずはプロンプトを調整しましたが、それだけでは解消しない問題が残りました。そこで、「どこまでをLLMに任せ、どこからを周囲の仕組みであるハーネス側で制御するか」という役割分担を見直しました。本記事では、実際に行った3つの改善と、今後の検討としてSLM(Small Language Model:小規模言語モデル)を発話分類に活用する案を紹介します。
なお、本記事はPoCでの検証事例です。本番運用での効果を定量的に評価した結果ではなく、検証中に見つかった問題と設計上の対応を整理したものです。
シリーズ関連記事


INDEX
1. AI受付では、会話だけでなく「順番」を守る必要がある
Virtual Conciergeは、来訪者と会話しながら担当者を特定し、来訪予定を確認して、担当者へ通知するAI受付システムです。
通常の流れは「言語選択→担当者検索→検索結果確認→予定確認→通知」です。「検索結果確認」は、検索で見つかった候補が来訪者の探している相手で正しいかを確認する段階です。
受付の途中では、「もう一度」「少し待って」「受付を終了したい」といった発話が、どの段階でも入る可能性があります。これらは発話の意味に応じて、その後に行う処理をあらかじめ決めやすいものです。本記事では、こうした発話を「定型発話」と呼びます。詳しい扱いは問題3で説明します。
受付では、来訪者のさまざまな言い方を理解する柔軟さが必要です。一方で、「今どの段階にいるのか」「次にどの段階へ進むのか」といった受付フローは、決められた順番で安定して進める必要があります。
図1:Virtual Conciergeの受付フロー
※図は設計の考え方を分かりやすくするために簡略化した概念図です。
2. 初期構成では、受付フローの進行までLLMに任せていた
PoCの初期構成では、会話の解釈に加えて、利用するツールの選択、状態(現在の受付段階)と遷移(次に進む段階)の判断、ツール実行後の応答までLLMに広く任せていました。つまり、LLMが受付フロー全体の進行まで判断する、エージェント的な構成です。シンプルで始めやすい一方、LLMが担う役割は多い構成でした。
図2:PoC初期構成(概念図)
もちろん、図2に示すように、LLMだけでシステム全体が動くわけではありません。LLMの周囲には、その動作を支える仕組みがあり、本記事ではこれらをまとめて「ハーネス」と呼びます。
「ハーネス」は馬具を意味する英語でもあります。LLMを馬に例えると、その力を目的に合わせて活用するための道具のようなものです。 具体的には、プロンプトや会話履歴の管理、担当者検索や通知などのツール連携、状態管理や分岐処理などが含まれます。なお、「ハーネス」が指す範囲は製品や文脈によって異なります。
初期構成にもこうした仕組みはありましたが、受付フローをどう進めるかという判断の多くはLLMに任せていました。
検証時の補足
同じ構成でも、問題の現れ方はモデルや実行環境によって異なりました。検証時点ではGemini 2.5 FlashやGPT-4oなどのクラウドLLMで基本的な受付フローを比較的安定して進められた一方、社内環境のgpt-oss-20bでは、検索結果にない情報を話す、必要な確認を飛ばす、現在とは異なるツールを呼ぶ、過去の会話に引っ張られるといった問題が目立ちました。ただし、これはモデル規模や推論設定、ツール呼び出しの特性、実行環境などを切り分けた性能比較ではありません。ここでは、条件によって問題の現れ方が変わった事例として紹介しています。
問題が目立った当初は、まずシステムプロンプトの指示を見直し、受付手順やツールの使い方をより明確にしました。しかし、それだけでは十分に安定しない部分が残りました。
そこで、プロンプトの調整だけを続けるのではなく、問題が起きている箇所に応じて、応答や状態・遷移などハーネス側の役割まで見直すことにしました。振り返ると、初期構成は、指示の曖昧さや設計上の隙間をモデルが吸収することに、ある程度依存していました。
ここからは、PoCで実際に見つかった三つの問題を、「LLMに任せていた何を、どこまでハーネス側へ移したのか」という観点で順に見ていきます。
3. 問題1:ツール結果は正しいのに、応答内容がずれる
担当者検索ツール自体は正しい候補を返していました。しかし、LLMがその結果をもとに来訪者への応答を生成すると、まだ来訪予定を確認していない段階で、検索結果にない面会時刻や会議室を作り、「〇時、〇〇会議室でよろしいでしょうか」と案内してしまうことがありました。正しい情報を取得できていても、応答生成時に根拠のない情報が加わる「ハルシネーション」の問題です。
改善:ツール結果から決まる応答はハーネス側で返す
そこで、ツール結果から返す内容を決められる部分は、LLMに自由生成させず、ハーネス側で応答の形を決めました。例えば担当者候補が見つかった場合は、検索結果に含まれる候補名などを決まった文型に差し込んで、まず担当者候補が正しいかだけを確認します。候補がない場合は、聞き直し用の応答を返します。来訪予定は、その後の予定確認の段階で扱います。
これにより、この時点では状態・遷移の判断はLLM側に残しつつ、担当者検索の段階で、未確認の予定情報を付け加えて案内する余地を減らす構成にしました。
図3:問題1の改善前・後
4. 問題2:受付の段階を取り違え、処理の順番を間違える
問題1を改善した後も、現在の状態と次の遷移を決める役割はLLM側に残っていました。そのため、担当者検索の途中なのに予定確認へ進む、必要な検索結果確認を飛ばす、すでに終わった処理へ戻るといったことがありました。
受付では、会話内容だけでなく、「今どの状態にいるか」「次にどこへ遷移するか」が処理の順番を決めます。今回のPoCでは、ここまでをLLMの判断だけに任せると、受付フローそのものが安定しない場合がありました。
改善:状態・遷移をハーネス側で制御する
そこで、「言語選択」「担当者検索」「検索結果確認」「予定確認」という状態と、その間の遷移をハーネス側で明示的に制御する構成へ変更しました。
さらに各状態では、その処理に必要なプロンプト、利用できるツール、必要な会話履歴だけをLLMへ渡します。ハーネスが現在の状態を決め、その状態の中で必要な会話理解をLLMに任せる形です。
この切り替えの狙いは、LLMにその時点で不要な情報や選択肢を見せないことです。例えば担当者検索中に予定確認用のツールや指示を渡さなければ、現在の処理とは関係のない操作を選ぶ余地を減らせます。
図4:問題2の改善前・後
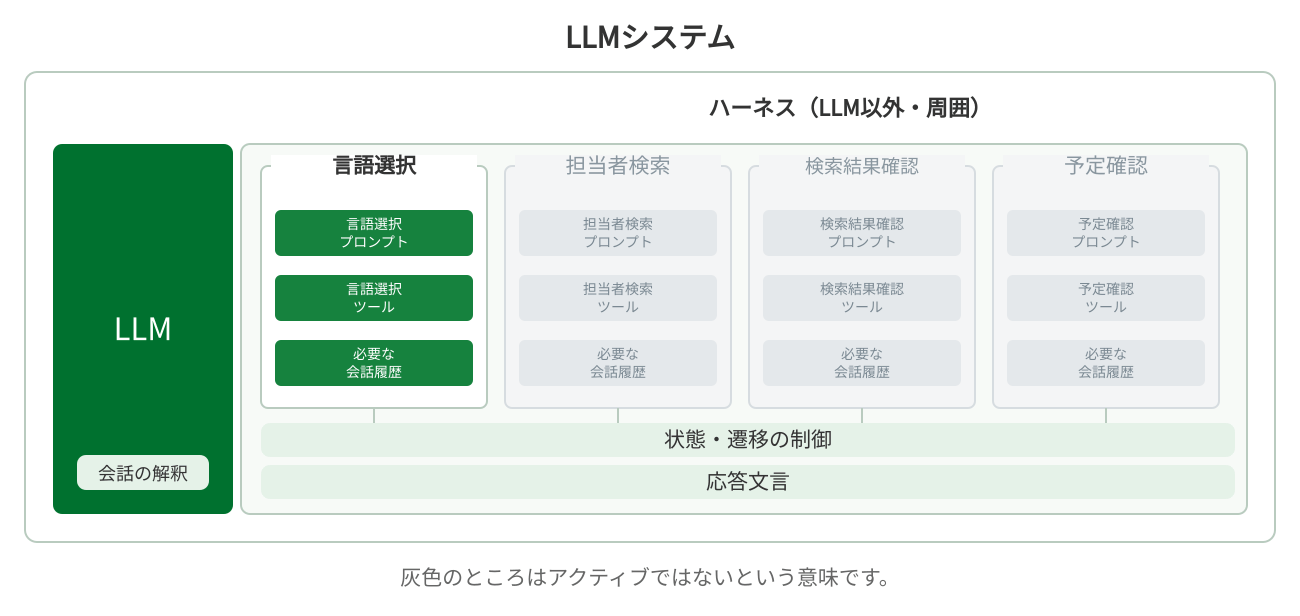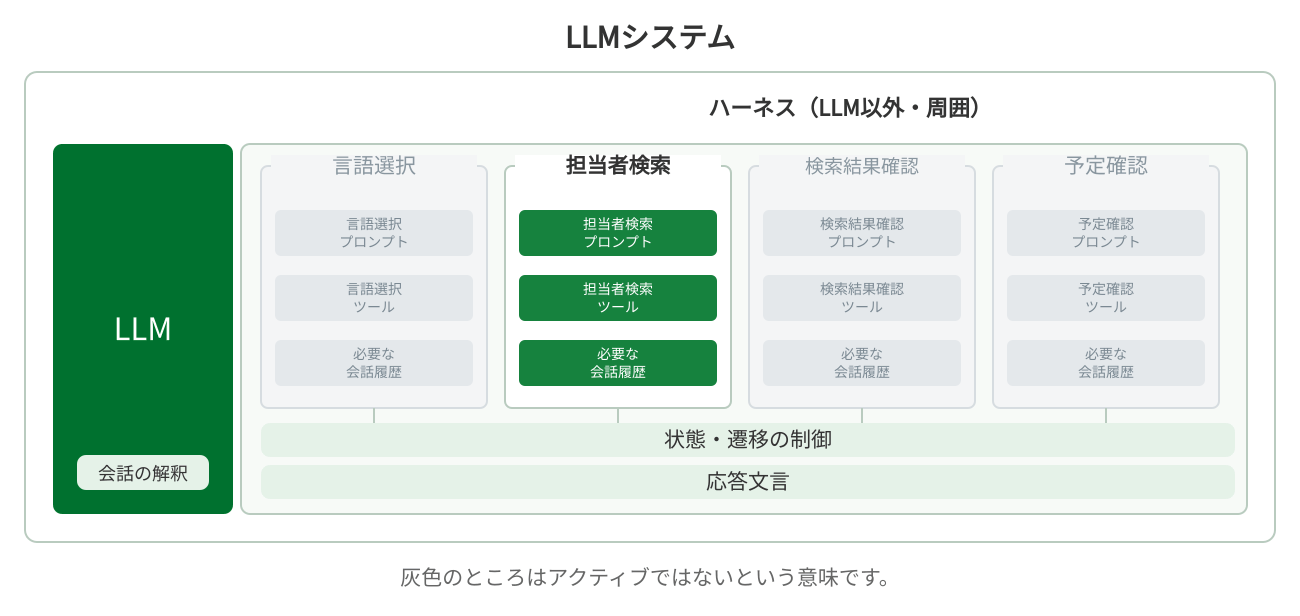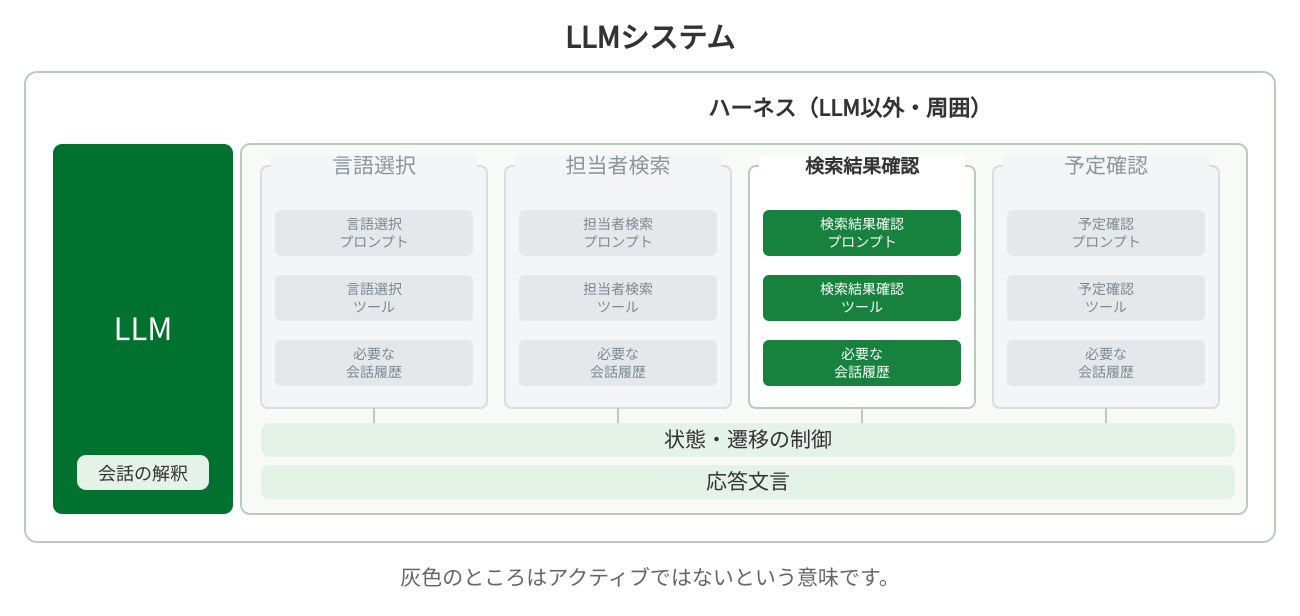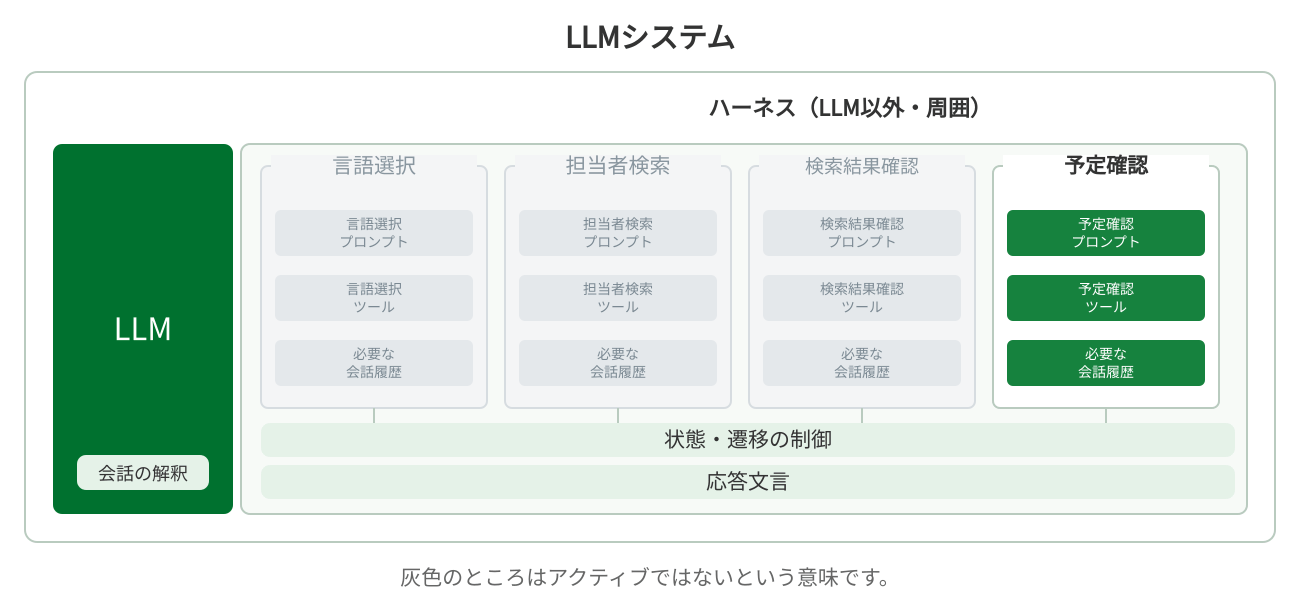
図5:受付段階ごとの情報切り替え(GIF)。灰色はその段階では使わない情報です。
5. 問題3:終了を求められていないのに、受付を終わらせようとする
社内テストでは、来訪者が終了を求めていないのに、LLMが受付終了の処理へ進もうとすることがありました。
問題2の改善後も、通常の受付処理に加え、「もう一度」「少し待って」「受付を終了したい」といった割り込み処理の指示を各状態のプロンプトに含めていました。そのため、例えば担当者検索中でも、LLMには受付終了を含む割り込み処理の選択肢が見えている状態でした。現在の処理と直接関係のない判断まで同時に求めることが、意図しない処理を選ぶ一因になっている可能性があると考えました。
改善:LLMへ渡す前に、発話を分類する
そこで、音声認識結果をLLMへ渡す前に、キーワードやルールで「通常の発話」「もう一度」「待機」「受付終了」などに分類します。通常の発話はメインLLMへ、定型発話は種類に応じて「直前の案内を繰り返す」「状態を維持して待つ」「終了確認へ進む」といった固定処理へ分けます。
ただしルールで分類する対象は、意味が明確で処理を固定しやすい発話に限定します。文脈が必要な発話まで細かくルール化すると、別の誤分類を生む可能性があるためです。
図6:問題3の改善後
これにより、通常の受付フローと「もう一度」「待機」「受付終了」などの定型的な割り込みを分けて扱います。
6. 改善後の全体像
3つの改善を反映した構成が図7です。
図7:Virtual Conciergeの改善後の全体構成
ハーネスが定型発話の分類、状態・遷移の制御、ツール結果に応じた定型的な応答を担い、LLMには各状態で必要な会話理解を任せています。
この構成により、LLMの柔軟性を生かしながら、受付業務として守る必要がある処理順序を制御しやすくしました。
7. 今後の検討:SLMを前段に置いた定型発話分類
ここまでの改善では定型発話をルールベースで分類していますが、ルールだけでは言い換えや音声認識の揺れへの対応に限界があります。
次の検証では、この前段の分類にSLM(Small Language Model:小規模言語モデル)を使う案を検討しています。SLMに任せるのは、音声認識結果を「通常の発話」または各定型発話の種類に分類するところまでです。つまり、SLMをメインLLMの前段に置き、定型発話に該当するかを先に振り分ける構成です。分類後にどの処理を実行するかは引き続きハーネス側で決め、定型発話なら分類結果に応じた固定処理へ、通常の発話ならメインLLMへ渡します。
狙いは、単純な文字列一致では拾いにくい言い換えや、音声認識結果の揺れにも対応しやすくすることです。ただし、例えば「受付終了」と誤って分類すると、終了の意思がないのに終了確認へ進むなど、受付の流れを妨げる可能性があります。そのため、分類精度や誤分類時の挙動、応答時間を確認したうえで、採用を判断します。
図8:今後の検討――SLMを前段に置いた定型発話分類
8. まとめ:LLMの柔軟性を、必要な場所に集中させる
なぜこの役割分担にしたのか。Virtual Conciergeでは確認順序と次の処理があらかじめ決まっているため、発話理解にはLLMの柔軟性を使い、同じ条件なら同じ結果にしたい部分はハーネス側で支えました。
この構成には代償もあります。応答を固定する部分では、LLMに生成させる場合より表現の自由度が狭くなります。それでも今回の受付業務では、業務フローを安定させるメリットの方が大きいと判断しました。
ただし、これは万能な設計ではありません。LLMに任せる範囲は、業務の性質、モデルや実行環境、求める精度・応答速度などによって変わります。同じ業務でも条件が変われば、適した役割分担は変わります。
今回のPoCで得た大きな学びは、プロンプトだけに閉じないことです。まずプロンプトを見直し、それで安定しない部分だけ、応答、状態・遷移、定型発話の扱いへと見直す範囲を広げました。最初から複雑にするのではなく、問題の性質に応じて次に見直す場所を選ぶことが重要です。
重要なのは、LLMを減らすことでも、複雑な構成を作ることでもありません。システムが、業務で求められる役割を安定して果たせることです。プロンプトの調整も、ハーネスによる制御も、そのための手段です。今回のPoCでは、問題の性質に応じて見直す場所を変えながら、受付業務で求める動作を安定して実現できる構成を探っていきました。
次回は、第2回記事で紹介した3つの設計ポイントのうち、2つ目の「AIの出力を、そのまま業務上の事実として扱わない」を取り上げ、担当者の特定と予定情報の照合について掘り下げます。
(執筆・編集:Assawamanachai Napat)